はじめに
GASでローカルファイルを取り込む|Drive経由方式の記事(以下、Drive経由方式の記事)では、ローカルのExcelファイルをいったんGoogleドライブにアップロードし、スプレッドシート形式に自動変換してから中身をコピーする方法を検証しました。この方式はシンプルですが、①Advanced Google Services(Drive API)を有効にする準備が必要、②Driveへのアクセス権限が求められる、③変換用の一時ファイルを都度削除する後片付けが必要、という3つの手間がありました。
そこで今回は、Googleドライブを一切経由せず、ブラウザ側のJavaScriptライブラリ(SheetJS)を使って選択されたファイルをその場でパースし、パース済みのデータを直接google.script.runでサーバー側に渡すというクライアント側パース方式を実装・検証します。Drive経由方式の記事と同じ「取り込みたい」という目的に対する、もう一つのアプローチです。
クライアント側パース方式とは?全体像
今回実装する流れは次のとおりです。
①ファイル選択:HTMLフォームの <input type=”file”> でローカルファイルを選択
②パース:選択したファイルをブラウザ側でSheetJS(xlsx.js)ライブラリに読み込ませ、
その場でExcel/CSVの中身を2次元配列(VBAのRange.Valueに近い形)に変換
③送信:パース済みの2次元配列を google.script.run でそのままサーバー側に渡す
④転記:サーバー側は受け取った配列を setValues() で取り込み先シートに書き込むだけ
Drive経由方式の記事との最大の違いは、②の変換処理がサーバー側(Drive API)ではなく、クライアント側(ブラウザのJavaScript)で完結する点です。Googleドライブへのアップロードという工程自体が存在しないため、Drive APIの有効化も、変換用の一時ファイルの後片付けも不要になるはずです(実際にどうなるかはStep3以降で検証します)。
準備①:Apps ScriptエディタにHTMLファイルを追加する
Drive経由方式の記事と同じ手順でHTMLファイルを追加します。
- スプレッドシートのメニュー「拡張機能」→「Apps Script」でスクリプトエディタを開く
- 左側ファイル一覧の「+」アイコン→「HTML」を選択
- ファイル名は
ParseDialogと入力(拡張子は不要、自動的にParseDialog.htmlになる)
準備②:「取込先」シートを用意する
下記のコードは、データの書き込み先として取込先という名前のシートをgetSheetByName('取込先')で取得する前提です。Drive経由方式の記事のときと同様、あらかじめシート下部の「+」から「取込先」という名前のシートを追加しておいてください。
Step1:基本実装(ブラウザ内パース〜サーバーへの送信〜転記)
クライアント側(ParseDialog.html)
<!DOCTYPE html>
<html>
<head>
  <base target="_top">
  <script src="https://cdn.sheetjs.com/xlsx-0.20.2/package/dist/xlsx.full.min.js"></script>
  <style>
    body { font-family: sans-serif; box-sizing: border-box; padding: 4px 8px; }
    input[type="file"] { width: 100%; box-sizing: border-box; }
  </style>
</head>
<body>
  <p>取り込むファイルを選択してください(.xlsx / .xls / .xlsm / .csv)</p>
  <input type="file" id="fileInput" accept=".xlsx,.xls,.xlsm,.csv">
  <br><br>
  <label>取り込むシート名(Excelファイルのみ・省略時は先頭シート)</label><br>
  <input type="text" id="sheetNameInput" placeholder="例:取込対象">
  <br><br>
  <button onclick="upload()">取り込む</button>
  <p id="status"></p>

  <script>
    function upload() {
      const fileInput = document.getElementById('fileInput');
      const file = fileInput.files[0];
      if (!file) {
        document.getElementById('status').textContent = 'ファイルを選択してください。';
        return;
      }

      // 「取り込む」を押した時点から計測を開始し、パース〜サーバー転記までの所要時間を表示する
      const startTime = Date.now();

      document.getElementById('status').textContent = '読み込み中…';
      const sheetName = document.getElementById('sheetNameInput').value;

      const reader = new FileReader();
      reader.onload = function(e) {
        // ここがDrive経由方式との最大の違い:ブラウザ側でSheetJSを使ってその場でパースする
        const data = new Uint8Array(e.target.result);

        // CSVのみ文字コードを判定する(xlsx/xls/xlsmはバイナリ内に文字コード情報を持つため対象外)
        let workbook;
        if (/\.csv$/i.test(file.name)) {
          const hasBom = data[0] === 0xEF && data[1] === 0xBB && data[2] === 0xBF;
          // ブラウザ標準のTextDecoderで明示的にデコードしてから文字列としてSheetJSに渡す
          // (UTF-8 BOMがなければ、日本語Windows版Excelの既定保存形式であるShift-JISとして扱う)
          const text = hasBom
            ? new TextDecoder('utf-8').decode(data.slice(3)) // 先頭3バイト(BOM)を除いてデコード
            : new TextDecoder('shift-jis').decode(data);
          workbook = XLSX.read(text, { type: 'string' });
        } else {
          workbook = XLSX.read(data, { type: 'array' });
        }

        const targetSheetName = sheetName || workbook.SheetNames[0];
        const sheet = workbook.Sheets[targetSheetName];
        if (!sheet) {
          document.getElementById('status').textContent = `シート「${targetSheetName}」が見つかりませんでした。`;
          return;
        }

        // 2次元配列(VBAのRange.Valueに近い形)に変換
        const values = XLSX.utils.sheet_to_json(sheet, { header: 1, raw: true });

        document.getElementById('status').textContent = '転記中…';

        google.script.run
          .withSuccessHandler(function(msg) {
            const elapsedSec = ((Date.now() - startTime) / 1000).toFixed(1);
            document.getElementById('status').textContent = `${msg}(${elapsedSec}秒)`;
          })
          .withFailureHandler(function(err) {
            document.getElementById('status').textContent = 'エラー:' + err.message;
          })
          .importParsedData(values);
      };
      reader.readAsArrayBuffer(file);
    }
  </script>
</body>
</html>FileReaderでファイルを読み込む部分自体はDrive経由方式の記事と共通ですが、あちらがreadAsDataURLでBase64文字列に変換してサーバーに丸投げしていたのに対し、今回はreadAsArrayBufferで読み込んだバイナリをその場でSheetJSに渡してパースまで済ませてからサーバーに送っています。
補足: SheetJSはHTMLファイルの<head>内で<script src="...">によりCDN経由で読み込みます(GASには「参照設定」やnpm installに相当する仕組みがないため)。ダイアログは560×300pxで、ファイル名が省略表示にならないよう<input type="file">自体にwidth: 100%を指定しています。「取り込む」ボタン押下から完了までの経過時間も自動計測し「(◯.◯秒)」の形で表示しています。
注意:CSVファイルは文字化け対策が必要です。 日本語Windows版Excelの「CSV(カンマ区切り)」形式は既定でShift-JIS(cp932)ですが、XLSX.read()は文字コード未指定だとUTF-8として読み込むため不一致が起きます。codepageオプションはCSVの自動判定パスには効かないため、.csvの場合のみ先頭のUTF-8 BOMの有無を判定し、TextDecoder('utf-8')/TextDecoder('shift-jis')で明示的にデコードしてから文字列としてXLSX.read(text, { type: 'string' })に渡す方式で解決しています(xlsx/xls/xlsmはバイナリ内に文字コード情報を持つため対象外)。
サーバー側(Code.gs)
// ダイアログを開く
function showParseDialog() {
  const html = HtmlService.createHtmlOutputFromFile('ParseDialog')
    .setWidth(560)
    .setHeight(300);
  SpreadsheetApp.getUi().showModalDialog(html, 'ファイルを取り込む(クライアント側パース)');
}

// ダイアログ側から呼ばれる:パース済みデータを受け取って転記するだけ
function importParsedData(values) {
  if (!values || values.length === 0) {
    throw new Error('取り込んだファイルにデータがありませんでした。');
  }

  // 行ごとに列数が異なる場合があるため、最大列数に揃えてから書き込む
  const maxCols = values.reduce((max, row) => Math.max(max, row.length), 0);
  const normalized = values.map(function(row) {
    const filled = row.slice();
    while (filled.length < maxCols) filled.push('');
    return filled;
  });

  const targetSheet = SpreadsheetApp.getActiveSpreadsheet().getSheetByName('取込先');
  targetSheet.clearContents();
  // clearContents()は値だけをクリアし表示形式は残るため、前回インポート時に付いた書式
  // (日付形式など)が残って新しい値の見え方がおかしくなるのを防ぐため書式もクリアする
  targetSheet.clearFormats();

  // 書き込み行数がシートの現在の最大行数を超える場合は、あらかじめ行を追加して拡張する
  if (targetSheet.getMaxRows() < normalized.length) {
    targetSheet.insertRowsAfter(targetSheet.getMaxRows(), normalized.length - targetSheet.getMaxRows());
  }

  targetSheet.getRange(1, 1, normalized.length, maxCols).setValues(normalized);

  return `${normalized.length}行のデータを取り込みました。`;
}Drive経由方式の記事のimportFileViaDriveと見比べると、Drive.Files.createによるアップロード・変換や、try...finallyでの一時ファイル削除がまるごとなくなり、受け取ったデータを書き込むだけのシンプルな関数になっています。ただしvaluesの各行はSheetJSのsheet_to_jsonが返す配列のため列数が揃っていないことがあり、そのままだとsetValues()がエラーになるため、書き込み前に最大列数まで空文字で埋めています。
注意点は3つです。 ①数値セルは数値のまま取り込まれますが、「取込先」シートを使い回すと前回インポート時の表示形式(日付書式など)が残ったままになり、新しい数値が日付のように見えてしまうことがありました。clearContents()は値のみをクリアし表示形式は残る仕様のため、clearFormats()も併せて呼んで解消しています。②Googleスプレッドシートの新規シートは既定の行数が有限(VBAと異なりシートが自動で無制限に広がらない)なため、書き込み行数がgetMaxRows()を超える場合はinsertRowsAfter()で事前に拡張しています。③showParseDialog()はDrive経由方式の記事と同様、エディタの「実行」ボタンから直接実行するとCannot call SpreadsheetApp.getUi() from this context.エラーになることがあります(発生条件はプロジェクトによって異なる)。動作確認は次のStep2でシート上にボタンを設置してから行うことをおすすめします。
Step2:ボタンから実行できるようにする
GASでボタンから実行する方法(VBAのシートボタンに相当)と同じ「図形にスクリプトを割り当てる」方法で、シート上にボタンを設置します。
- メニュー「挿入」→「図形描画」で図形を作成
- 図形を選択した状態で右上の「︙」→「スクリプトを割り当て」
- 関数名に
showParseDialogと入力
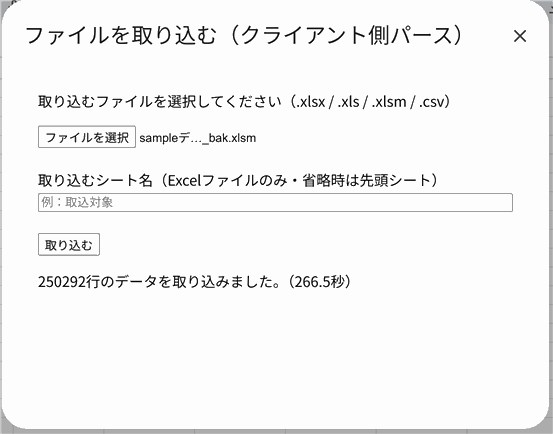
これでボタンを押すとファイル選択ダイアログが開きます。
Step3:注意点|スピル関数(動的配列)の変換結果
Drive経由方式の記事では、スピル関数(動的配列)を含むファイルを取り込むとスピル先の周囲セルが空白になる制約がありましたが、クライアント側パース方式ではこの問題は発生しません。 SheetJSは表示されている計算結果を読み取る仕組みのため、スピル先も含めてそのまま静的な値として書き込まれます(数式自体はなくなります)。
例外として、FORMULATEXT()で他セルの数式を文字列表示していたセル(例:=MAXIFS(D2:D101,E2:E101,"*"&G4:G14&"*")という文字列)は、=始まりの文字列がsetValues()で書き込まれるとGoogleスプレッドシート側に数式と解釈され、生きた数式として書き込まれます(スピルはしないが数式としては機能)。特殊な使い方のため実務上の影響は限定的です(Drive経由方式の記事でも類似の現象を確認済み)。
★超大量データでの「シートが見つからない」エラーについて
約100万行のExcelファイルは、シート名が正しくエラー表示も一切ないまま「シートが見つかりませんでした」というエラーで失敗します(25万行までは成功するため、単純な行数の多さではなく、さらに巨大なデータ量でのみ発生する別の制約です)。
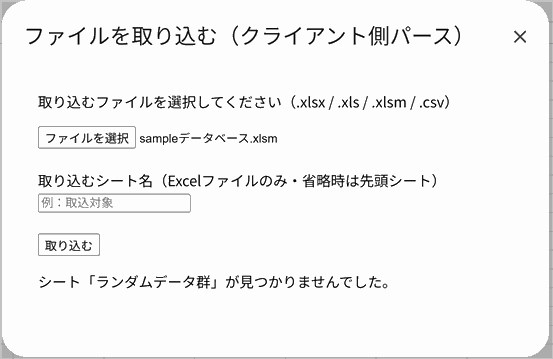
原因はSheetJS公式のIssue #563で報告されている既知の制約と考えられます。SheetJSはxlsx展開時に各シートのXMLを一度JavaScript文字列に変換しており、その文字列サイズがJavaScriptエンジン(V8)の上限(当時で約256MB)を超えると変換に失敗するというものです。シート名は別の小さいXMLから読めるため正しく表示される一方、本体データの方は生成できず「シートが見つからない」という一見不可解なエラーになります。GASのダイアログもChrome上のV8を使うため同種の上限があると考えられますが、100%同一原因との断定はできません(❓完全には未確定)。
実務上の対策: Issue #563ではXLSB形式への保存し直しで回避できたと報告されています。数十万行を超える超大量データはあらかじめファイルを分割するか、Drive経由方式の記事の方法を検討することをおすすめします。
できること・できないことの整理
| 項目 | 結果 |
|---|---|
| ローカルのExcelファイル(.xlsx)を取り込む | ✅ 25万行(約175万セル)まで成功を確認 |
| Advanced Google Services(Drive API)の有効化 | ✅ 不要(Drive経由方式の記事と異なり、この方式では確認不要と確認) |
| Driveへのアクセス権限 | ✅ 不要(確認済み) |
| 一時ファイルの後片付け | ✅ そもそも発生しない(ブラウザのメモリ上だけで処理が完結) |
| エディタの「実行」ボタンから直接実行 | ⚠️ 今回のテストでは制約なし。Drive経由方式の記事同様、プロジェクトによって挙動が異なる可能性がある |
| 対応ファイル形式(.xls/.xlsm) | ✅ 問題なく取り込みに成功 |
| .csvファイルの取り込み | ✅ Shift-JIS(BOMなし)で文字化けを確認したが、BOM判定+TextDecoderによるデコードで解消を確認 |
| 「取込先」シートの行数不足への対応 | ✅ 書き込み前にinsertRowsAfter()で自動拡張するよう対応済み |
| 超大量データ(100万行規模)での取り込み | ❌ 「シートが見つからない」エラーで失敗。V8の文字列サイズ上限が原因と考えられる(詳しくはStep3) |
| 大きめのファイルでのパース所要時間 | ✅ 同一CSV(32,486行)で比較:Drive経由方式の記事は約14秒、クライアント側パース方式は9.0秒。Excel25万行は247.5秒(回によって266.5秒などブレあり) |
| 取り込まれるシート(先頭シート/シート名指定) | ✅ 未指定時は先頭シート、指定時は該当シートを正しく取り込むことを確認 |
| 通常の数式・値の変換結果 | ✅ 数値は数値のまま取り込まれる。ただし「取込先」シート使い回し時に前回の日付書式が残留する現象があり、clearFormats()で対応済み(詳しくはStep1) |
| スピル関数(動的配列)の変換結果 | ✅ スピル先を含め表示値がそのまま書き込まれる(Drive経由方式の記事のような値の欠落は起きない)。ただしFORMULATEXT()で数式文字列を表示していたセルは、生きた数式として書き込まれる例外あり |
| SheetJS(CDN経由)の読み込み自体が成功するか | ✅ CDN経由での読み込み・パースとも成功を確認 |
上記は実機検証を経て確定した結果です。
まとめ
- クライアント側パース方式は、ブラウザ側のJavaScriptライブラリ(SheetJS)でファイルをその場でパースし、パース済みデータを直接
google.script.runでサーバーに渡す方式 - Drive経由方式の記事と違い、Googleドライブへのアップロード・変換・一時ファイルの削除という工程が不要(Advanced Google Services・Driveへのアクセス権限も不要)
- サーバー側の関数(
importParsedData)は受け取ったデータをsetValues()で書き込むだけとシンプル。ただし「取込先」シートの行数不足への自動対応と、前回インポート時の書式残留対策(clearFormats())が必要 - SheetJSはHTMLファイル内で
<script src="...">によりCDN経由で読み込む(GASには「参照設定」やnpm installに相当する仕組みがないため) - Drive経由方式の記事で見つかったスピル関数の変換不備(スピル先が空白になる問題)は、クライアント側パース方式では発生しない。表示されている値がそのまま静的な値として取り込まれるため
- 同一ファイルでの速度比較では、クライアント側パース方式の方がDrive経由方式より高速だった(CSV32,486行で9.0秒 対 約14秒)
- 一方、約100万行規模の超大量データでは「シートが見つからない」というエラーで失敗する制約がある(V8エンジンの文字列サイズ上限が原因と考えられる)。数十万行を超えるような超大量データはこの方式には不向き
次回予告
次回GAS第8回の記事では、Drive経由方式(前回の記事)とクライアント側パース方式(今回の記事)を比較し、実装コスト・対応ファイル形式・必要な権限・処理速度などの観点で整理する予定です。
サンプルファイルについて
この記事で使用したテスト用スプレッドシートはこちらからダウンロードできます。
関連記事
- 【検証】生成AIはVBAをGoogle Apps Scriptに変換できるか?Office Scriptsとの違いも解説
- 【検証】GASでHtmlServiceダイアログの進捗表示を実装する|6分の実行時間上限も回避できた
- 【検証】GASでセルベースの進捗表示×時間主導型トリガーの連鎖で6分の壁を回避できるか
- GASの進捗表示2方式をVBA目線で比較
- 【GAS】PropertiesServiceとは?CacheServiceとの違い・3つのスコープの使い分けを解説
- GASでローカルファイルを取り込む|Drive経由方式
- 【Excel VBA】ファイルを開いてデータを取得する(その1)
- 【Excel VBA】ファイルを開いてデータを取得する(その2)
※1回買えば複数サイトで使い回しOK
当サイトの記事で使用したVBAなどのサンプルをDLできます
ダウンロードページへは下のカードをクリックすればジャンプできます。
よろしければご利用ください!